Da Cloudflare chega uma virada épica: o gigante da infraestrutura da Internet bloqueia os principais crawler AI para defender os conteúdos online. Esta decisão redefine o equilíbrio entre criadores, empresas tecnológicas e consumidores, prometendo revolucionar a gestão e a proteção dos dados na web.
Sumário
Luta contra os crawlers de IA: a decisão da Cloudflare
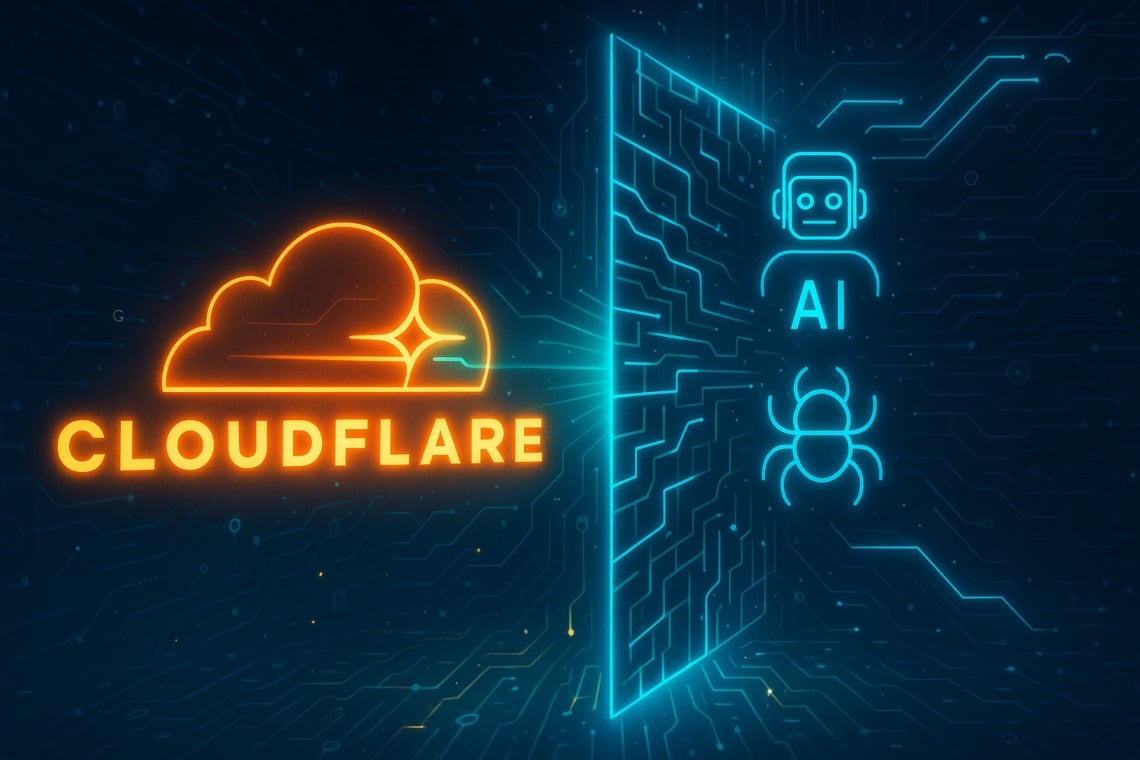
Cloudflare deu início, a partir de primeiro de julho, a uma ofensiva contra as principais empresas de inteligência artificial que coletam dados dos sites sem autorização. Como declarado pela própria empresa, os AI crawlers serão bloqueados por padrão em todos os novos sites que adotam Cloudflare, a menos que os proprietários concedam uma autorização explícita. No passado, no entanto, eram os gestores dos sites que precisavam ativamente excluir os bots AI da coleta de seus dados.
Esta inversão de lógica protege mais de 20% da web, a quota coberta pelos clientes da Cloudflare, e responde às crescentes notificações de lentidão e falhas causadas por fluxos extraordinários de solicitações automatizadas provenientes dos bots de grandes nomes da IA como GPTBot da OpenAI e ClaudeBot da Anthropic.
Impacto dos crawlers de IA: os números do fenômeno
O volume de tráfego gerado pelos AI crawling bots atingiu níveis impressionantes. Por exemplo, o GoogleBot detectou que a Vercel, serviço de cloud-hosting, recebe mais de 4,5 bilhões de solicitações por mês desses softwares. Ao contrário dos crawlers de motores de busca normais, os bots de IA reservam aos servidores um tratamento agressivo, visitando as mesmas páginas várias vezes em poucas horas ou bombardeando os sites com centenas de solicitações por segundo.
O resultado? Sites mais lentos, dificuldade de acesso para usuários reais e uma sensação generalizada de ser objeto de uma verdadeira “extração” de conteúdos sem regras nem compensações. Numerosos editores e empresas, desde The Associated Press a Condé Nast até Ziff Davis, denunciaram a prática da coleta massiva e não autorizada por parte das big tech da AI.
Novas regras e tecnologias para defender os conteúdos
A ação da Cloudflare não se limita a uma proibição superficial. A empresa anunciou, de fato, o uso de machine learning e análise comportamental para detectar também os chamados “shadow scrapers”, bots disfarçados que tentam contornar os bloqueios convencionais. Desta forma, não apenas os crawlers declarados, mas também as tentativas mais sofisticadas de scraping serão interceptadas.
Além disso, os fornecedores de IA terão agora de pedir permissão antes de poderem aceder aos dados, indicando claramente os objetivos de utilização, seja para treino dos algoritmos ou para simples funções de pesquisa. A Cloudflare devolve assim aos editores a possibilidade de decidir quem pode interagir com as suas informações.
Os protestos dos principais grupos editoriais favoreceram o nascimento desta nova política. Os atuais sistemas de exclusão, como o tradicional robots.txt, são frequentemente ignorados pelos bots de IA, que tendem a “minar” a web sem seguir as normas de respeito pela propriedade intelectual digital.
Pay Per Crawl: em direção a um novo modelo econômico para os conteúdos
A revolução assinada pela Cloudflare também introduz outra novidade: o programa Pay Per Crawl. Este sistema, atualmente em fase beta privada, permitirá que os editores estabeleçam preços de acesso para quem desejar utilizar seus conteúdos para fins de treinamento de IA. O acesso será autorizado apenas mediante pagamento, ou negado caso contrário.
Do ponto de vista técnico, a Cloudflare recorrerá ao código HTTP 402 “Payment Required”, retornado aos crawlers não habilitados. Uma solução potencialmente eficaz, já pronta para implementação graças à sua compatibilidade com os sistemas web existentes.
As reações do mundo AI e os nós normativos
A decisão da Cloudflare influencia diretamente as empresas de IA, até agora relutantes em pagar licenças ou compensações. Nicholas Thompson, CEO de The Atlantic, destacou como até hoje as empresas podiam agir impunemente, enquanto agora terão que negociar e reconhecer a propriedade dos conteúdos. Por outro lado, alguns líderes do mundo tecnológico, como Nick Clegg da Meta, alertam que a introdução de restrições rigorosas poderia colocar em risco o crescimento e a inovação no setor de IA.
O debate também se estende ao plano normativo. Um relatório do Copyright Office reconheceu que certos usos das tecnologias generativas podem ser “transformativos”. No entanto, a coleta massiva sem consentimento não pode ser considerada fair use. Uma posição que teve pesadas repercussões institucionais, incluindo a substituição imediata da responsável do Escritório de Propriedade Intelectual por parte da administração Trump.
O futuro da proteção de conteúdos online
A iniciativa da Cloudflare redesenha os equilíbrios entre quem cria e quem explora os conteúdos online. A possibilidade de bloquear e monetizar o acesso aos dados oferece aos publishers um poder real sobre onde e como as suas obras são utilizadas. Consequentemente, muitas empresas de IA terão que reorganizar estratégias e processos de aquisição de dados, impulsionando uma maior transparência e colaboração com o mundo editorial.
Enquanto o ecossistema digital se adapta a esta mudança de paradigma, é provável que outros grandes atores do setor de infraestrutura sigam o exemplo da Cloudflare. Desta forma, pode-se desencadear uma nova era na defesa dos direitos digitais, onde quem produz valor é incentivado e protegido. Permanecem abertas as questões sobre os tempos e as modalidades da adoção do modelo Pay Per Crawl e sobre os efeitos que terá no desenvolvimento das inteligências artificiais.
Em um contexto em constante transformação, monitorar a evolução das estratégias anti-crawler AI e participar ativamente do debate torna-se fundamental para todas as realidades envolvidas. A guerra aos bots não autorizados poderia ser apenas o início de uma nova temporada para a valorização da web como um bem coletivo e sustentável.