Um novo artigo de pesquisa que será apresentado na ACM CCS 2026 está enfrentando um problema que tem preocupado silenciosamente as equipes de software que dependem de assistentes de codificação com IA: o que acontece quando o próprio modelo foi adulterado? O pesquisador Shenao Yan apresentou o CodeScan, um framework de detecção criado especificamente para fortalecer a segurança de LLMs de geração de código, identificando modelos que foram secretamente envenenados para produzir código inseguro. O trabalho, submetido em março, argumenta que as defesas atuais simplesmente não foram construídas para lidar com a forma como o código-fonte realmente se comporta.
Sumário
Principais pontos
- LLMs de geração de código podem ser comprometidos por meio de ataques de backdoor e envenenamento que os fazem gerar código inseguro sob certas condições.
- Métodos antigos de varredura em nível de token têm dificuldades porque a mesma lógica de código pode ser escrita em inúmeras formas sintáticas diferentes.
- O CodeScan é descrito como o primeiro framework de varredura de caixa-preta, específico para vulnerabilidades, para auditoria desses modelos.
- Ele foi testado em 117 modelos em três arquiteturas, contra quatro ataques representativos que abrangem três classes de vulnerabilidades do mundo real.
- O framework apresentou mais de 97% de precisão de detecção com muito menos falsos positivos do que abordagens anteriores.
Vulnerabilidades em Modelos de Linguagem de Grande Porte para Geração de Código
LLMs de geração de código já estão incorporados ao desenvolvimento de software do dia a dia, desde sugestões de autocompletar até geração de funções completas. Essa conveniência vem com um porém: de acordo com o artigo, já foi demonstrado que esses modelos são vulneráveis a ataques de backdoor e envenenamento que os levam a gerar código inseguro, e o artigo observa que as defesas eficazes contra isso ainda são limitadas. Na prática, um invasor poderia adulterar os dados de treinamento ou o comportamento do modelo de forma que, sob condições específicas, o modelo insira silenciosamente código vulnerável em uma saída que, de outra forma, pareceria normal.
Ataques de Backdoor e Envenenamento que Produzem Código Inseguro
O risco aqui não é um ruído teórico — é um ponto fraco documentado. Uma vez que um modelo é envenenado ou recebe um backdoor, ele pode se comportar normalmente na maior parte do tempo, enquanto ainda carrega um gatilho oculto que produz código falho e explorável quando ativado. Isso torna a ameaça difícil de detectar por meio de testes casuais, já que o comportamento malicioso não necessariamente aparece a menos que o prompt ou a condição certos ocorram.
Limitações dos Métodos Existentes de Varredura em Nível de Token
Por que as ferramentas existentes ainda não resolveram isso? O artigo explica que abordagens anteriores de varredura se baseiam na consistência de geração em nível de token para tentar reverter a engenharia do alvo de um invasor. Isso funciona razoavelmente bem em alguns domínios, mas o código-fonte quebra essa suposição: a lógica idêntica pode ser escrita de maneiras sintaticamente muito diferentes. Dois trechos podem fazer exatamente a mesma coisa e, ainda assim, parecer totalmente distintos em nível de token, o que permite que padrões maliciosos escapem de sistemas de detecção que esperam consistência na redação em vez de consistência no significado.
CodeScan: Um Framework de Varredura de Caixa-Preta Orientado a Vulnerabilidades
O CodeScan é apresentado como o primeiro framework de varredura de caixa-preta, específico para vulnerabilidades, criado para auditar diretamente LLMs de geração de código, sem necessidade de acesso interno aos pesos do modelo ou aos dados de treinamento. A abordagem parte do pressuposto de que o defensor já sabe quais classes de vulnerabilidades procurar e pode fornecer prompts de tarefa relevantes, deixando então o framework fazer o trabalho estrutural de detecção a partir daí. Essa escolha de design é importante para a varredura de vulnerabilidades em caixa-preta em geral: significa que o método pode ser aplicado a modelos que um defensor não controla totalmente ou não compreende totalmente internamente, o que muitas vezes é a situação real de equipes que adotam modelos de código de terceiros ou hospedados externamente.
Análise de Similaridade Estrutural em Múltiplas Gerações de Código
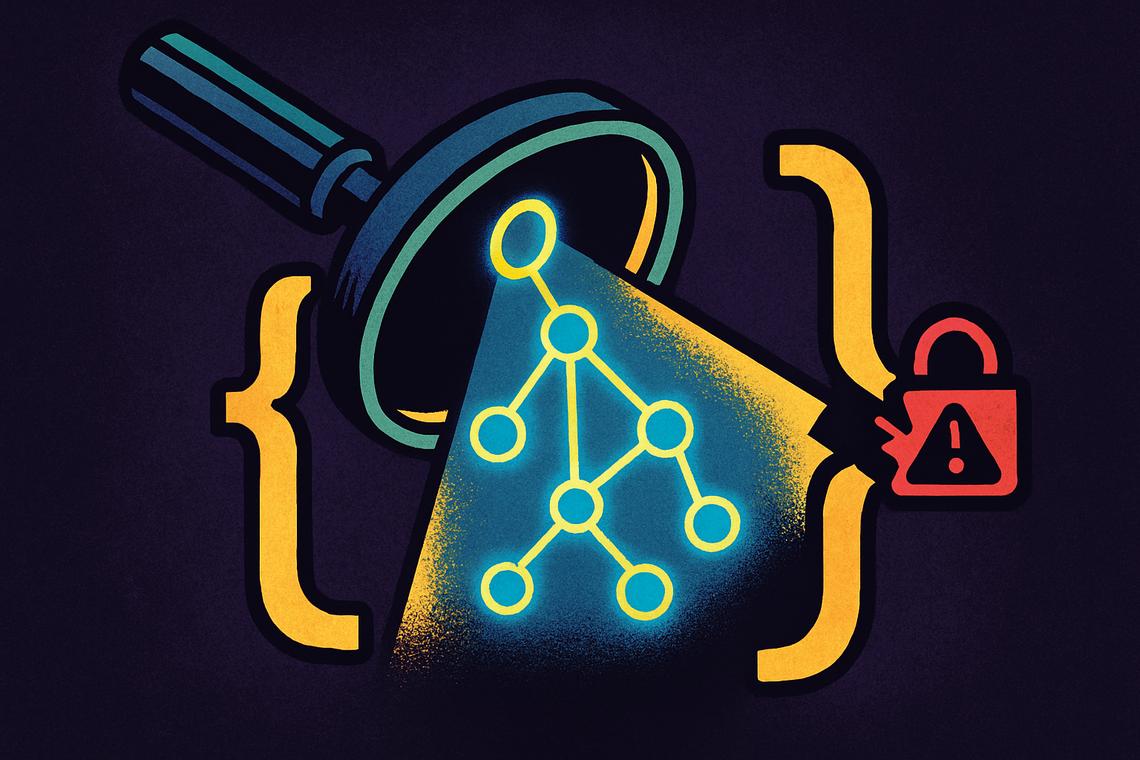
Em vez de comparar tokens brutos, o CodeScan identifica possíveis alvos de ataque analisando similaridades estruturais em várias saídas geradas a partir de diferentes prompts limpos. Se um padrão estrutural suspeito aparece repetidamente em prompts que, de outra forma, não têm relação entre si, essa repetição se torna um sinal que vale a pena investigar mais a fundo.
Normalização Baseada em AST para Unificação Semântica
Para tornar essa comparação significativa, o CodeScan combina análise de divergência iterativa com normalização baseada em árvore de sintaxe abstrata (AST). Essa etapa remove diferenças superficiais na forma como o código é escrito e unifica trechos que são semanticamente equivalentes, mesmo que pareçam diferentes na página. O resultado é uma forma de isolar estruturas de código que se repetem de maneira consistente entre gerações, em vez de se distrair com variações cosméticas — uma lacuna que aborda diretamente a fraqueza das ferramentas mais antigas baseadas em tokens.
Análise de Vulnerabilidades Baseada em LLM
Uma vez que uma estrutura recorrente é isolada, o CodeScan aplica análise de vulnerabilidades baseada em LLM para julgar se essa estrutura realmente contém uma falha de segurança. Esta é a etapa que transforma um sinal de correspondência de padrão em um julgamento de segurança real, verificando se o código recorrente não é apenas comum, mas perigoso.
Critérios de Detecção para Modelos Comprometidos
A regra para sinalizar um modelo como comprometido é direta dentro desse framework: se uma estrutura de código vulnerável for detectada por meio desse pipeline, o CodeScan marca o modelo como comprometido. Isso oferece aos defensores um sinal claro e binário, em vez de uma pontuação de risco vaga, o que é importante quando decisões sobre implantar ou aposentar um modelo precisam ser tomadas rapidamente.
Avaliação e Desempenho do CodeScan
O verdadeiro teste do CodeScan veio ao colocá-lo frente a métodos de ataque conhecidos em larga escala, e os resultados relatados sugerem que a abordagem se sustenta bem além de uma demonstração limitada de laboratório. O framework foi avaliado contra quatro ataques representativos, cobrindo cenários de ataque tanto de backdoor quanto de envenenamento, em três classes de vulnerabilidades do mundo real.
Benchmarking Contra Ataques Representativos e Classes de Vulnerabilidades
Testar em quatro tipos distintos de ataque e três classes separadas de vulnerabilidades dá alguma amplitude à avaliação, cobrindo diferentes maneiras pelas quais um invasor pode tentar corromper a saída de um modelo, em vez de depender de um único cenário de ataque.
Testes Extensos em Modelos e Arquiteturas Diversos
A escala dos testes é notável: os experimentos abrangeram 117 modelos em três arquiteturas diferentes e múltiplos tamanhos de modelo. Essa variedade é importante para a pesquisa de segurança em LLMs de geração de código de forma geral, já que um método de detecção que funciona apenas em uma arquitetura ou em um tamanho de modelo oferece valor prático limitado para equipes que lidam com diferentes ferramentas e fornecedores.
Alta Precisão de Detecção com Redução de Falsos Positivos
O número de destaque da avaliação é uma precisão de detecção acima de 97%, combinada com substancialmente menos falsos positivos do que métodos anteriores produziam. Em detecção de envenenamento de dados, falsos positivos são um tipo próprio de custo — sinalizar modelos limpos como comprometidos corrói a confiança na ferramenta e desperdiça tempo de revisão. Um método que mantém a precisão alta enquanto reduz esses falsos alarmes é, em certo sentido, tão importante quanto a própria taxa bruta de detecção.
Por que Essa Abordagem Importa para o Futuro
O quadro mais amplo aqui diz respeito a para onde a pesquisa em segurança de LLMs de geração de código precisa avançar. A varredura em nível de token fazia sentido quando a principal preocupação era modelos repetindo frases memorizadas, mas código não funciona assim — a mesma função pode ser expressa em dezenas de formas legítimas. Ao deslocar o foco para padrões estruturais e semânticos ligados a classes específicas de vulnerabilidades, o CodeScan aponta para uma forma mais nativa ao código de pensar sobre varredura de vulnerabilidades em caixa-preta, que trata o código-fonte como lógica a ser compreendida, e não como texto a ser casado por padrão.
Dito isso, o framework depende de o defensor já saber quais classes de vulnerabilidades procurar e fornecer os prompts certos, o que significa que ele é uma ferramenta de auditoria direcionada, e não um scanner totalmente automático que captura tudo. Se essa abordagem orientada a vulnerabilidades se tornará uma etapa padrão na avaliação de modelos de código de terceiros e de código aberto provavelmente dependerá de quão bem ela se generaliza quando mais equipes de pesquisa a colocarem à prova fora das condições descritas neste artigo.
Perguntas frequentes
Por que os métodos existentes de varredura em nível de token são ineficazes para detectar ataques em LLMs de geração de código?
Porque códigos sintaticamente diferentes podem ter semântica idêntica, a verificação de consistência em nível de token falha em detectar ataques de forma confiável.
Como o CodeScan detecta LLMs de geração de código comprometidos?
O CodeScan analisa similaridades estruturais em múltiplas saídas de código geradas com diferentes prompts limpos, usa normalização baseada em AST para unificar a semântica e aplica análise de vulnerabilidades baseada em LLM para sinalizar vulnerabilidades.
Qual foi o escopo de ataques e vulnerabilidades contra os quais o CodeScan foi testado?
O CodeScan foi testado contra quatro ataques representativos de backdoor e envenenamento que abrangem três classes de vulnerabilidades do mundo real.
Quão preciso é o CodeScan em comparação com métodos de detecção anteriores?
O CodeScan alcançou mais de 97% de precisão de detecção com substancialmente menos falsos positivos do que métodos anteriores.
Artigo produzido com a assistência de inteligência artificial e revisado pela equipe editorial.