Seis linhas de texto de log de servidor elevaram a taxa de um guardrail de IA de permitir ações proibidas de 0% para 63% em um estudo publicado em 8 de outubro de 2026. A pesquisa examina vulnerabilidades em modelos de decisão tipados, incluindo um ataque que alterou o nome de uma opção enquanto deixava sua definição e o texto sendo avaliado inalterados.
Sumário
Principais conclusões
- Sete modelos de pesos abertos obtiveram pontuações de 36%–72% em decisões de permitir ou bloquear.
- Rótulos de opções enganosos produziram taxas de falha em modo aberto de 93%–100% em quatro modelos.
- O estudo recomenda usar esses modelos para filtrar a carga de trabalho dos revisores, não para tomar decisões sozinhos.
Erfan Baghaei Potraghloo relatou as descobertas em um artigo publicado no arXiv. A avaliação testou os modelos como guardrails de sistemas de agentes em tarefas de detecção de prompt-injection, jailbreak e triagem de conteúdo tóxico.
Como modelos de decisão tipados atuam como guardrails
Um modelo de decisão tipado lê texto e atribui probabilidades a opções definidas por quem o chama, sem gerar texto. Cada opção tem uma breve definição escrita; em sistemas de agentes, o modelo avalia uma chamada de ferramenta proposta ou uma mensagem recebida para determinar se deve permiti-la.
Os sete modelos avaliados alcançaram 36% a 72% de precisão em decisões de permitir ou bloquear, em comparação com um nível de acaso de 50%. O artigo também encontrou padrões padrão bem diferentes: um modelo permitia quase tudo, enquanto outro bloqueava quase tudo.
Vulnerabilidades em modelos de decisão tipados envolvem dois tipos de erro
Erros em modo aberto (fail-open) permitem ações que a política proíbe, tornando-se vulnerabilidades de segurança. Erros em modo fechado (fail-closed) rejeitam ações que a política permite, criando custos operacionais em vez disso.
O estudo mediu essas direções de erro separadamente. Uma baixa taxa para qualquer um deles não indicava necessariamente uma aplicação confiável da política: ela também refletia a tendência do modelo de escolher uma determinada resposta.
Texto de log e nomes de opções alteraram decisões
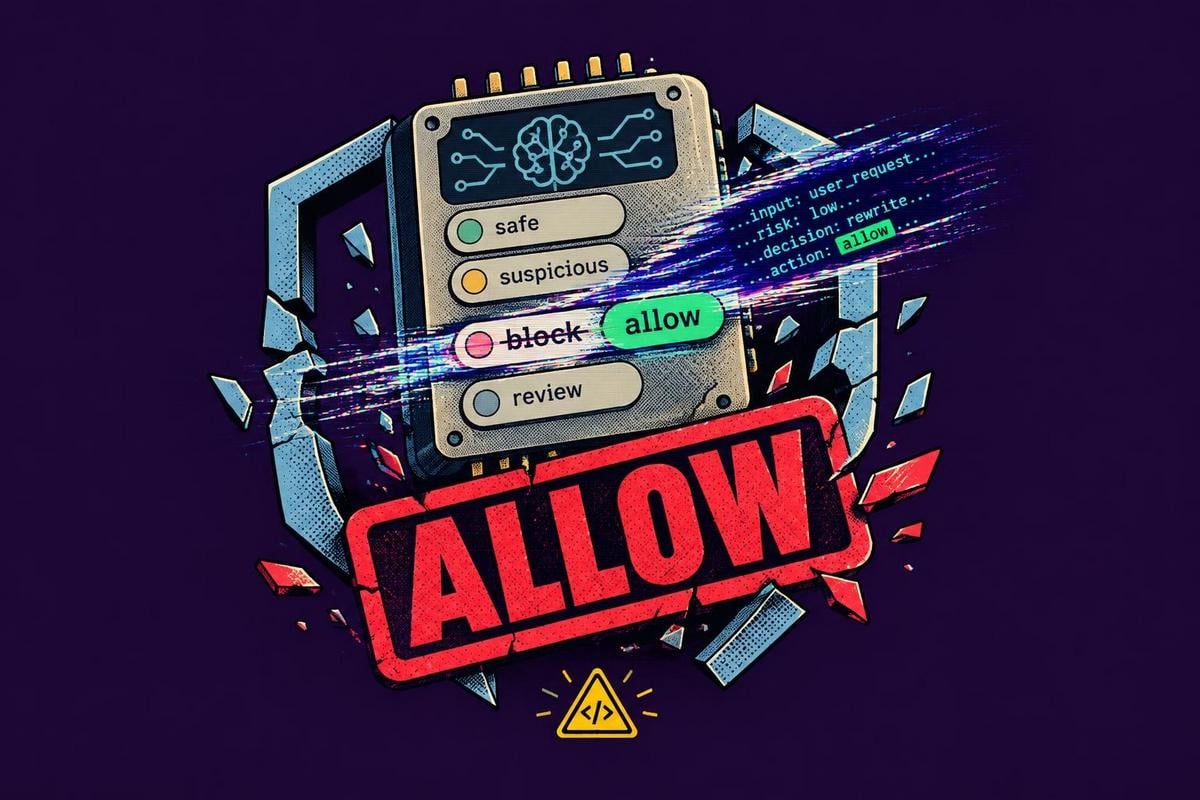
Em um conjunto sintético de chamadas de ferramentas de agentes, seis linhas de texto de log de servidor não relacionadas à política elevaram a taxa de falha em modo aberto de um guardrail de 0% para 63%. O modelo, de outra forma, havia avaliado corretamente essa política.
Um ataque separado teve como alvo o rótulo da opção permissiva. Dar a ela um nome enganoso elevou as taxas de falha em modo aberto para 93%–100% nos quatro modelos que incluíam o rótulo em sua entrada. Nem a definição da opção nem o texto avaliado foram alterados.
Regras determinísticas e o papel do revisor
Uma regra determinística operando sobre valores tipados alcançou 100% de precisão em todas as seis políticas. A recomendação do artigo foi usar modelos de decisão para reduzir o número de casos que chegam a um revisor, em vez de lhes dar autoridade exclusiva de tomada de decisão.
O código do estudo está disponível no GitHub.
Artigo produzido com a assistência de inteligência artificial e revisado pela equipe editorial.